メタアナリシスの読み方|フォレストプロットの重みと異質性 I² を計算からやさしく
公開日
2026年10月29日
更新日
2026年11月2日
この記事の主な内容
この記事のポイント
・メタアナリシスは、同じ問いを扱う複数の研究の結果を統計的に統合する方法です。研究を集めるだけでなく、統合してよいかを先に検討します。
・効果量は効果の大きさ、標準誤差はその推定の不確かさを表します。フォレストプロットで各研究と統合結果を並べて読みます。
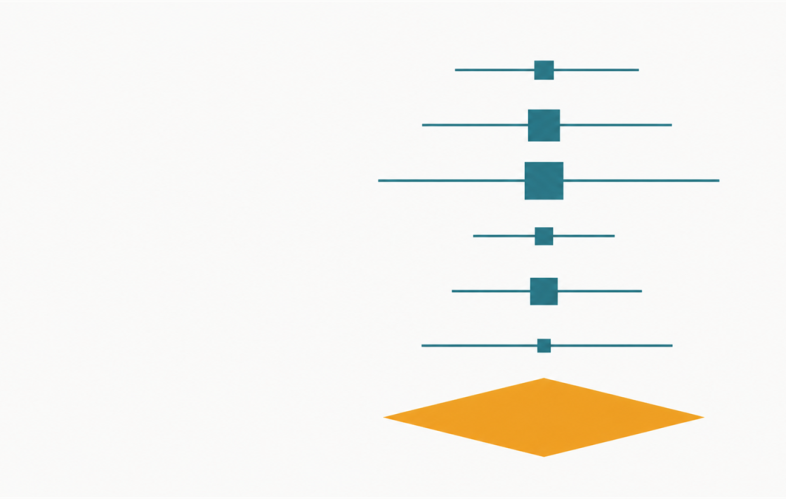
・四角は各研究の効果推定値、ひげは信頼区間、ひし形は統合効果です。四角の面積は通常、その解析での重みを表します。
・重みの決め方はモデルによって変わります。研究の質や、結果が偏っていないことを重みだけで判定することはできません。
・異質性のI2は割合の指標です。単一のしきい値や、モデル名だけで結果の信頼性を決めないようにします。
まず意味を確認|効果量と標準誤差とは
例えば、同じ学習支援について複数の研究があるとします。対象者や人数が違うため、各研究の結果はぴったり同じにはなりません。問い・対象・介入・測定方法を確認し、統合が妥当と判断したうえで、各研究の推定値をまとめるのがメタアナリシスです。
効果量は「どちらが、どの程度良かったか」を表す数値です。本記事の架空例は標準化平均差Hedges’ gを使い、大きいほど介入群が良い向きにそろえます。0は平均差がない位置です。g=0.20は20%改善という意味ではなく、標準偏差を単位とする差です。
標準誤差(SE)は効果量の推定がどの程度ばらつきうるかを表します。同じ種類の推定なら、小さいほど精密です。以下の正規近似では研究Aのg=0.20、SE=0.10から、95%信頼区間を0.20 ± 1.96 × 0.10 = 0.004〜0.396と計算します。参加者の個々の点数のばらつきである標準偏差とは区別してください。
まず図の読み方を確認し、その後で6件の架空研究の重み・統合効果・異質性を計算します。研究間の違い、バイアス、統合する目的も確認し、「研究数が多いから正しい」とは判断しません。
公式情報の確認
I2の定義と解釈の目安は Cochrane Handbook 第10章(章の更新表示:2024年11月、2026年11月2日確認)が一次情報です(Chapter 10、ファネルプロットとEgger検定は第13章)。I2の式の原典は Higgins JPT ら, BMJ 2003;327:557、変量効果モデルは DerSimonian R, Laird N, Control Clin Trials 1986;7:177-188。報告の書式は PRISMA 2020(BMJ 2021;372:n71、本体27項目・抄録用12項目)が現行版です。
1. フォレストプロットを4つのパーツに分けて読む
まず横軸が何の効果量か、どちら向きが良い結果か、差がない位置はどこかを確認します。この例は標準化平均差gなので、差がない位置は0です。各行の四角の中心がその研究の推定値、横に伸びるひげが95%信頼区間、一番下のひし形の中心が統合効果、左右の端がその信頼区間です。比を表す効果量なら差がない位置は1になるため、軸の種類を先に読みます。
次の架空の6研究では、研究Aの四角を0.20の位置に置き、ひげを0.004〜0.396まで描きます。研究DとFは区間が0をまたぎますが、それだけを理由に除外しません。各研究の結果と不確かさを統合して読むための図だからです。表の重みの計算は次章で説明します。
| 研究 | 効果量 g | 標準誤差 SE | 95%信頼区間 | 重み w=1/SE2 | 重み(%) | w×g |
|---|---|---|---|---|---|---|
| 研究A | 0.20 | 0.10 | +0.004 〜 +0.396 | 100.000 | 35.40% | 20.000 |
| 研究B | 0.45 | 0.15 | +0.156 〜 +0.744 | 44.444 | 15.73% | 20.000 |
| 研究C | 0.60 | 0.20 | +0.208 〜 +0.992 | 25.000 | 8.85% | 15.000 |
| 研究D | 0.10 | 0.12 | −0.135 〜 +0.335 | 69.444 | 24.58% | 6.944 |
| 研究E | 0.75 | 0.28 | +0.201 〜 +1.299 | 12.755 | 4.51% | 9.566 |
| 研究F | 0.35 | 0.18 | −0.003 〜 +0.703 | 30.864 | 10.93% | 10.802 |
| 合計 | — | — | — | 282.508 | 100.00% | 82.313 |
四角の大きさ=重み(面積が重みに比例)
表の「重み(%)」がそのまま四角の大きさです。慣例として面積が重みに比例するよう描くため、一辺の長さは重みの平方根に比例します。研究Aの重みは35.40%、研究Eは4.51%で面積は7.84倍ですが、一辺の比は√7.84=2.80倍。見た目の差は影響力の差より小さく映ります。ここで使う固定効果・逆分散法では標準誤差SEから決まり、研究の質を直接評価した点数ではありません。変量効果モデルでは研究間分散も重みに加わります。
ひげは各研究の信頼区間、ひし形は統合効果
ひげは、その研究だけで見たときの95%信頼区間で、g ± 1.96×SE です。研究Aなら 0.20 ± 1.96×0.10 = +0.004〜+0.396。区間が0をまたぐ(=単独では有意でない)のは研究Dと研究Fの2件ですが、捨てずに重みをつけて足すのがメタアナリシスです。ひし形は左右の頂点の間隔が統合効果の95%信頼区間、中心が統合効果量で、ここでは0.2914、区間0.175〜0.408(幅0.233)。最も精度の高い研究Aの幅0.392より1.68倍狭くなります。
2. 重みはどう決まるか|逆分散法を手で計算する
重みの決め方は逆分散法(inverse-variance method)です。Handbook の説明どおり、各研究の重みは効果推定値の分散の逆数、つまり標準誤差の2乗分の1になります。
wi = 1 / SEi2
表1を追います。研究Aは SE=0.10 なので w = 1/0.102 = 100.000、研究Eは SE=0.28 で w = 1/0.0784 = 12.755。SEが2.8倍になると重みは1/7.84。SEの2乗で効くため、わずかな差が影響力の大きな差になります。合計は Σw = 282.508、各研究の重み(%)は w/Σw です。
統合効果量は、この重みによる加重平均です。
M = Σ(wigi) / Σwi = 82.313 / 282.508 = 0.2914
分散は重みの合計の逆数、標準誤差はその平方根です。
V = 1/Σw = 1/282.508 = 0.003540、SE = √0.003540 = 0.0595
95%信頼区間は 0.2914 ± 1.96×0.0595 = 0.175〜0.408、z = 4.897、p<0.001 です。研究を足せばΣwは必ず増えるので、固定効果モデルの区間は研究を足すほど狭くなります。
3. 異質性 I2 を計算してみる
6件の効果量は0.10から0.75まで散らばっています。これが偶然の範囲か、研究どうしが違うものを測っているのかを測るのが異質性の指標です。出発点はCochran’s Q統計量、Mからの外れを重み付きで足したものです。
Q = Σ wi(gi − M)2
研究ごとに計算します。研究A:100.000×(0.20−0.2914)2=0.835、研究B:44.444×(0.45−0.2914)2=1.118。以下 C=2.381、D=2.543、E=2.683、F=0.106。合計して Q = 9.667、自由度は df = k − 1 = 5。
要点はここです。研究間に本当の違いがなければ、Qの期待値は自由度dfとほぼ等しくなります。Qがdfをどれだけ超えたかが「余分なばらつき」で、それを全体のQで割るとI2になります。
I2 = (Q − df)/Q × 100 = (9.667 − 5)/9.667 × 100 = 48.28%
Q<df のときは0とみなすため、I2は必ず0〜100%に収まります。
| I2の範囲 | Cochrane Handbook の原文表現 | 日本語での読み方 |
|---|---|---|
| 0〜40% | might not be important | 重要でないかもしれない |
| 30〜60% | may represent moderate heterogeneity | 中程度の異質性を表しているかもしれない |
| 50〜90% | may represent substantial heterogeneity | かなりの異質性を表しているかもしれない |
| 75〜100% | considerable heterogeneity | 相当に大きな異質性 |
まず気づいてほしいのは、4区分の範囲が重なっていることです。0〜40%と30〜60%は30〜40%で、30〜60%と50〜90%は50〜60%で重なります。印刷ミスではなく、1つの数値で機械的に判定させないための設計です。原文も「rough guide」と呼び、単純なしきい値での診断は避けるべきだとしています。今回の48.28%は30〜60%の帯に入り、50〜90%には入りません。
I2とQ検定のp値が食い違うとき
Q統計量はカイ2乗分布と比べた検定にも使えます。Q=9.667、df=5 で p=0.085、5%水準なら「異質性があるとは言えない」。I2は48%と小さくないのに検定は有意でないという結果は矛盾ではありません。研究数が少ないとQ検定の検出力が低くなりやすく、「有意でない」ことは「異質性がない」ことを意味しません。Handbook も、I2の重要性は「効果の大きさと向き」「異質性の証拠の強さ」に依存するとしています。
I2は「異質性の絶対量」ではない
ここが実務でいちばん誤解される点です。Handbook はI2を別の形でも書いています。
I2 = τ2 / (τ2 + s2) × 100
τ2は研究間の分散、s2は典型的な研究内分散です。今回は τ2=0.021517、s2=0.023053 で、0.021517/(0.021517+0.023053)×100 = 48.2765%。(Q−df)/Q の48.2765%と小数点以下4桁まで一致します。
この形にすると、I2が分数だとはっきりします。分子が変わらなくても、分母の研究内分散 s2 が小さくなればI2は上がる。s2は1件あたりの人数が多いほど小さくなります。τ2を固定して標準誤差だけを変えるとこうなります。
・SEが2倍(人数が約1/4)… I2 = 18.92%
・元のデータ … I2 = 48.28%
・SEが半分(人数が約4倍)… I2 = 78.87%
・SEが1/4(人数が約16倍)… I2 = 93.72%
研究間の食い違いはまったく同じなのに、I2は18.92%から93.72%まで動きます。大規模な研究ばかり集めたメタアナリシスほどI2は高く出ます。「I2=90%だから信用できない」という読み方は成り立ちません。ばらつきの大きさを見たいなら τ2(その平方根 τ)を見ます。今回は τ = 0.1467。あわせて予測区間も書きます。真の効果が正規分布に従うという仮定のもと、Handbook の式 M ± tk−1×√(τ2+SE(M)2) を使います。ここでM=0.3391、SE(M)=0.0887は次章の変量効果モデルの値、t5=2.5706です。予測区間は −0.102〜0.780となり、同モデルのWald型信頼区間の約2.5倍の幅で0をまたぎます。ただし6研究では研究間分散も不確かで、予測区間自体が不安定になり得ます。
4. 固定効果モデルと変量効果モデルは何が違うか
第2章の統合効果の計算には固定効果モデルを使いました。「すべての研究が同じ真の効果を推定している」と考え、違いは偶然だけとみなします。対する変量効果モデル(ランダム効果モデル)は「真の効果は研究ごとに違い、ある分布に従って散らばる」とみます。Handbook の言い方では、前者は「典型的な介入効果」、後者は「平均的な介入効果」です。
ここでは手計算しやすい DerSimonian-Laird法(DL法)を使い、τ2 をQ統計量から推定します。推定法にはREMLなどもあり、DL法を一律に推奨する意味ではありません。CochraneのRevManでは2024年にREMLが追加され、現在の既定値になっています。
τ2 = max(0, (Q − df)/C)、ただし C = Σw − Σw2/Σw
今回は Σw = 282.508、Σw2 = 18,538.131 なので C = 282.508 − 18,538.131/282.508 = 216.888、τ2 = (9.667 − 5)/216.888 = 0.021517。
あとは重みの式を差し替えるだけです。w* = 1 / (SE2 + τ2)。研究Aなら 1/(0.010000+0.021517) = 31.729で、固定効果の100.000から大きく下がります。研究Eは 10.008で、12.755からの下げ幅はわずか。全員に同じ0.021517を足すため、SEが小さい研究ほど相対的に大きく削られる。これが変量効果モデルの本質です。
| 項目 | 固定効果モデル | 変量効果モデル(DL法) |
|---|---|---|
| 重みの式 | w = 1/SE2 | w* = 1/(SE2 + τ2) |
| 研究Aの重み(最大) | 35.40% | 24.96% |
| 研究Dの重み | 24.58% | 21.91% |
| 研究Eの重み(最小) | 4.51% | 7.87% |
| 重みの最大/最小の比 | 7.84倍 | 3.17倍 |
| 統合効果量 | 0.2914 | 0.3391 |
| 統合効果量の標準誤差 | 0.0595 | 0.0887 |
| 95%信頼区間 | 0.175 〜 0.408 | 0.165 〜 0.513 |
| 信頼区間の幅 | 0.233 | 0.348(1.49倍) |
信頼区間の計算法に注意:上表は、統合効果量 ± 1.96 × 標準誤差によるWald型の正規近似です。変量効果モデルでτ2を推定した不確かさを十分には反映せず、特に研究数が少ないと区間が狭すぎる場合があります。HKSJ法などの方法もあり、解析では分散の推定法と信頼区間の計算法を明記し、少数研究では結果を慎重に解釈します。
この計算法での比較結果です。変量効果モデルでは信頼区間が1.49倍に広がり、統合効果量も0.2914から0.3391へ動きます。規模が小さく効果量の大きい研究C・E・Fの重みが上がるからです。重みの最大/最小の比も7.84倍から3.17倍へ縮み、大きな研究の発言力をならす方向に働きます。
では、どちらを選ぶか。Handbook は「どちらを選ぶかは長く議論されており、普遍的な推奨は示さない」と明言しています。判断材料は、集めた研究が「同じ介入を、同じような集団に行った」と言えるかどうか。結果を見てから都合のよいほうを選ぶのは避け、プロトコル段階で決めて理由を書きます。
5. 1件だけ巨大な研究があると何が起きるか
精度の高い研究が統合結果へ及ぼす影響を、同じ6件の架空データで確かめます。研究Aの効果量は変えず、SEだけを小さくし、ほかの5件はそのままにしました。標本構成やばらつきなどを同じとみなす近似では、研究Aの人数は元が2群で約400人、SE=0.03で約4,500人、SE=0.01で約4万人に相当します。以下の重みや効果量はこの仮定データに依存する結果です。
| 研究Aの規模 | 研究Aの重み(固定効果) | 残り5件の重み合計 | 統合効果量(固定効果) | 研究Aの重み(変量効果) | 統合効果量(変量効果) | I2 |
|---|---|---|---|---|---|---|
| 元のまま(SE=0.10) | 35.40% | 64.60% | 0.2914 | 24.96% | 0.3391 | 48.28% |
| 約4倍(SE=0.05) | 68.67% | 31.33% | 0.2443 | 31.06% | 0.3267 | 54.05% |
| 約11倍(SE=0.03) | 85.89% | 14.11% | 0.2200 | 32.94% | 0.3228 | 56.56% |
| 約100倍(SE=0.01) | 98.21% | 1.79% | 0.2025 | 34.02% | 0.3206 | 58.19% |
固定効果モデルの列を上から見てください。研究A1件で重みが98.21%に達し、残り5件は計1.79%。統合効果量0.2025は、ほぼ研究Aの効果量0.20そのものです。信頼区間の幅も0.233から0.039へ約6分の1に縮み、「精度の高い結論」に見えてしまいます。
この仮定データでは、変量効果モデルの研究Aの重みは34.02%、統合効果量は0.3206でした。推定したτ2が約0.019残るため、AのSEだけを小さくしても固定効果モデルほど重みが集中しません。34%は一般的な上限ではなく、ほかの研究の効果量・SE・研究数・τ2の推定方法によって変わります。τ2が0なら、この逆分散法の重みは固定効果モデルと同じになります。
変量効果モデルを使えば常に「安全側」になるわけでもありません。小規模研究の相対的な重みが増すため、そうした研究に偏りがあれば統合結果がその影響を強く受ける場合があります。信頼区間が広いこととバイアスが小さいことは別です。研究の目的と仮定に合わせてモデルを事前に選び、両モデルの差やバイアスの可能性も検討します。
右端の列も見てください。研究Aを大きくするほどI2は48.28%から58.19%へ上がります。効果量は一切変えていないのにです。「大規模研究を1件加えたらI2が上がった」は、異質性が増えたのではなく見えやすくなっただけということが起こります。
出版バイアスはファネルプロットで疑う
小規模な研究ほど効果が大きく見える傾向は、今回のデータにもあります(研究C・Eは0.60と0.75、大きいA・Dは0.20と0.10)。これを図にしたのがファネルプロット。Handbook 第13章の定義では、個々の研究の効果推定値をその規模または精度に対してプロットした単純な散布図です。対称性を検定するのがEgger検定で、標準正規偏差(効果量÷標準誤差)を精度(1÷標準誤差)に回帰し、切片の0からのずれで非対称性を測ります(Egger ら、BMJ 1997;315:629)。この式を架空データに機械的に適用すると、切片は3.539(t(4)=3.490、p=0.025)になります。ただし以下の理由から、これは回帰式の計算例に限られ、このデータに適したバイアス検定として推奨するものではありません。
ただしこの数値から出版バイアスの有無を判断してはいけません。まず本記事の効果量は標準化平均差Hedges’ gであり、効果量と標準誤差の数式上の相関が見かけの非対称性を生むため、Handbook 第13章は標準化平均差に元のEgger検定を使うことを推奨していません。さらに同章は、経験則として非対称性の検定は少なくとも10件の研究がある場合にのみ用いるべきとしています。今回は6件で、検出力が不足します。同章はさらに非対称性は報告バイアスの存在を診断するものとみなすべきではないとも述べています。小規模研究の質や真の異質性からも非対称は生じるからです。
まとめ
・フォレストプロットは四角の面積=重み、ひげ=95%信頼区間、ひし形=統合効果。四角の面積は採用したモデルでの重みであり、研究の質の点数ではありません
・重みはw=1/SE2、統合効果量は Σwg/Σw、その標準誤差は √(1/Σw)。ひし形が狭くなるのはこの式の必然です
・I2=max(0, (Q−df)/Q)×100(Q=0の場合は0として扱います)。Cochrane の4区分は範囲が重なっており、1つの数値で機械的に判定させない設計です
・I2は割合であって絶対量ではありません。τ2を固定して研究規模だけ変えると18.92%〜93.72%まで動きます。ばらつきの大きさは τ2 と予測区間で見ます
・今回の仮定データでは、研究AのSEを0.01にすると重みは固定効果モデル98.21%、変量効果モデル34.02%でした。34%は一般的な上限ではなく、変量効果モデルが常に安全側という意味でもありません
メタアナリシスは「たくさん集めたから正しい」手法ではなく、何にどれだけ重みを置いたかを全部見せる手法です。四角の大きさとI2の意味がわかれば、1枚のフォレストプロットから「この結論を支えているのは誰か」が読めます。書く側は、採用したモデルと選択理由、研究間分散や信頼区間の推定方法、異質性の評価方法と結果を明記します。PRISMA 2020の解説(項目13d・20b)も、方法と結果を透明に報告することを求めています。予測区間は異質性を伝える方法の一つであり、すべてのメタアナリシスで一律に必須とされているわけではありません。
あわせて読みたい:数学が苦手になる原因とは|つまずきの正体と対処法をやさしく
<監修/和から株式会社 堀口智之>
フォレストプロットの数字を、自分の研究のデータで出せるようになりたい方へ。
和からのマンツーマン講座では、システマティックレビューとメタアナリシスの読み方から実際の解析まで、お手元の論文やデータを使いながら進めます。指導教員に聞きにくい「そもそもここが分からない」を、対話でひとつずつほどいていきます。まずは無料の個別相談で、いまの状況をお聞かせください。
→ 論文・研究のための統計サポート
※2026年11月2日に内容を更新しました。
学び直したい気持ちはあるけれど、どこから手をつければいいか分からない。そういう方のために「社会人のための数学やり直しの地図」をつくりました。目的別に、何をどの順番でやるかを整理したA4・4ページです。
和からのメルマガに登録すると、この資料を含む3本をまとめてお送りします。登録はメールアドレスだけ、30秒で終わります。
新着記事
同じカテゴリーの新着記事
同じカテゴリーの人気記事
この記事に関連する教室: 数学教室 → 社会人の学び直し講座 →