生成AIで勉強は大丈夫?Z世代62.6%が利用、信頼48.5%|数学10問でAIの間違いを検証
公開日
2026年9月14日
更新日
2026年9月14日
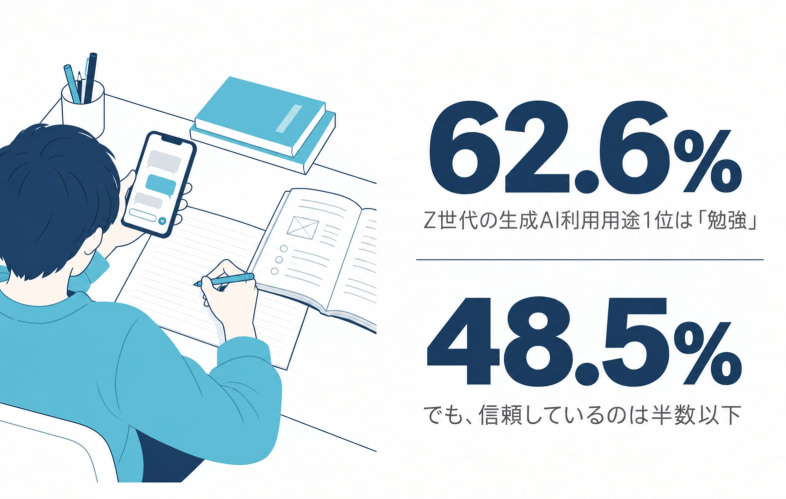
楽天が2026年9月4日に公表した「Z世代における生成AI利用に関する調査」によると、15〜25歳の生成AI利用用途の1位は「勉強・学習」(62.6%)でした。趣味の情報検索(47.0%)や悩み相談(30.9%)を大きく引き離しています。
ところが同じ調査で、学習の場面で生成AIの情報を「信頼している」と答えたのは48.5%。半数以上は、信頼しきれないものを毎日のように勉強に使っていることになります。
和からには「AIで勉強できるなら講座は要らないのでは」という問いが、受講検討中の大人からも、和からジュニアの保護者からも届きます。この記事では、講師が実際にZ世代と同じ使い方を再現して、その問いに正面から答えます。
この記事の主な内容
調査の要点
| 項目 | 数値 |
|---|---|
| ほぼ毎日利用する | 38.0% |
| 用途1位:勉強・学習 | 62.6% |
| 用途2位:趣味の情報検索 | 47.0% |
| 用途3位:悩み相談 | 30.9% |
| 学習シーンで生成AIの情報を「信頼している」 | 48.5% |
| 最も重視する情報源:検索エンジン | 42.1% |
出典:楽天グループ「Z世代における生成AI利用に関する調査」(2026年9月4日公表、15〜25歳の楽天学割ユーザー637名、調査期間2026年7月1日〜8月3日)
https://corp.rakuten.co.jp/news/press/2026/0904_01.html
この数字の読み方に一つだけ注意
回答者は楽天学割の会員です。学割サービスに登録するほどデジタル接触が強い層が自分で選んで回答している「自己選択標本」なので、Z世代全体の値としては高めに出ている可能性があります。
また637名の調査で48.5%という比率は、95%信頼区間でおよそ±3.9ポイントの幅を持ちます。「約半数」という読み方が精一杯で、「48.5%」という小数まで意味があるわけではありません。
「信頼している48.5%」の何が危ういのか
AIを信頼すること自体は悪くありません。正しい答えを正しいと受け取るのは、学習として効率的です。
問題はその逆です。AIが間違えたとき、学習者がそれに気づけるか。気づけなければ、間違いをそのまま「勉強した」ことになります。
これを式にすると単純です。AIの正答率を p、学習者が誤りに気づける確率を s とすると、
間違いをそのまま覚えてしまう割合 = (1 − p) × (1 − s)
たとえばAIの正答率が90%、学習者が誤りに気づける確率が30%なら、(0.1)×(0.7)=7%。1学期に300問解けば、21問を間違ったまま覚える計算です。
気づける確率が80%まで上がれば、同じ条件で2%(6問)まで下がります。
つまり学習の成否を分けるのはAIの正答率 p ではなく、学習者側の s です。そしてこの s は、その単元を「すでにある程度分かっている人」にしか持てません。
この構造は、以前の記事で扱ったAIデスキリング(AIに頼るほど検証する力が落ちる)とオートメーション・バイアス(自動化された出力を人が疑わなくなる)の、学習版そのものです。s が低い人ほどAIを信頼し、信頼するほど s が育たない、という循環に入ります。
講師がZ世代の使い方を再現してみた
そこで和からの講師が、Z世代がやっているのと同じことをやってみました。中学数学から統計検定2級レベルまでの10問を、そのまま生成AIに解かせます。
採点は2軸です。
(a) AIの答えが正しいか
(b) AIが間違えたとき、その単元を学習中の人が「間違いだ」と気づけるか
(b) は次の3段階で講師が判定しました。
気づける度A:答えを見ただけでは気づけない(もっともらしい)
気づける度B:検算や具体例の代入で気づける
気づける度C:定義に戻れば気づける(ただし定義を知っている必要がある)
問題は、生成AIが間違えやすい型をあえて含めて選んでいます。「どこで間違えるか」を知ることが、s を上げる一番の近道だからです。
出題した10問と、それぞれの罠
問1(小学・割合)
ある商品の値段を20%上げてから20%下げると、元の値段に戻るか。
正答:戻らない(1.2×0.8=0.96倍)
罠:「戻る」と答える型
気づける度:B(100円で試せば分かる)
問2(中2・連立方程式)
x+y=10、x−y=2 を解け。
正答:x=6、y=4
罠:ほぼなし。計算問題の基準点として入れています
問3(中3・平方根)
a=−3 のとき、√(a²) の値は。
正答:3(√(a²)=|a|)
罠:「−3」と答える型
気づける度:C(平方根の定義に戻る必要がある)
問4(高1・場合の数)
6人を3人ずつの2組に分ける方法は何通りか。
正答:10通り(₆C₃÷2)
罠:20通りと答える型(組に区別がないのに2で割り忘れる)
気づける度:A(20は非常にもっともらしい)
問5(高2・条件付き確率)
子どもが2人いる家庭で、少なくとも1人が男の子だと分かった。2人とも男の子である確率は。
正答:1/3
罠:1/2と答える型
気づける度:B(男男・男女・女男の3通りを書き出せば分かる)
問6(高2・対数不等式)
log₀.₅ x > 2 を解け。
正答:0 < x < 1/4
罠:底が1未満なのに不等号の向きを変えず x > 1/4 とする型
気づける度:B(x=1を代入すると矛盾が出る)
問7(統計検定3級・中央値)
データ 3, 8, 1, 10, 7, 100 の中央値は。
正答:7.5(並べ替えて中央2つの平均)
罠:並べ替えずに中央を取る、または平均(21.5)と混同する型
気づける度:B
問8(統計検定2級・不偏分散)
データ 2, 4, 4, 4, 5, 5, 7, 9 の不偏分散は。
正答:32/7 ≒ 4.57(標本分散なら4)
罠:n で割って4と答える型。どちらも「分散」なので答えだけ見ると判別できない
気づける度:A
問9(統計検定2級・信頼区間)
「母平均の95%信頼区間が[48, 52]である」とは、母平均が95%の確率でこの区間にあるという意味か。
正答:違う(母平均は定数。同じ手順を繰り返したとき区間が母平均を含む割合が95%)
罠:「その通り」と答える型
気づける度:C(推定の定義を知らないと気づきようがない)
問10(統計検定2級・p値)
検定で p=0.03 が得られた。これは帰無仮説が正しい確率が3%という意味か。
正答:違う(帰無仮説が正しいと仮定したとき、観測以上に極端な結果が出る確率)
罠:問9と同じ
気づける度:C
結果
2026年9月時点の生成AI2種類に、同じ文面で1回ずつ質問しました(追加の指示なし。Z世代の「聞き方」に合わせています)。
モデルA:ChatGPT(GPT-5.6 Luna、推論量「軽」設定)
モデルB:Gemini 3.6 Flash
あえて最上位モデルや「じっくり推論」設定を使わなかったのには理由があります。
勉強中の学生が宿題や問題集を解きながらAIに聞くとき、求めているのは速い答えです。1問ごとに1分待つ設定は選ばれません。無料枠や標準プランで最初に出てくるのは、安くて速いモデルです。楽天調査で「ほぼ毎日利用」が38.0%という使い方も、この軽い設定で回っていると考えるのが自然です。
つまり「AIは最高性能でどこまで解けるか」ではなく「Z世代が実際に使っている設定で何が起きるか」を見るのが、この実験の目的です。各1回の試行なので「正答率」を語れるデータではなく、10問の結果と、誤りの中身を見るための実験です。
| 問 | 単元 | モデルA | モデルB | 間違えた場合の気づける度 |
|---|---|---|---|---|
| 1 | 割合 | ○ | ○ | B |
| 2 | 連立方程式 | ○ | ○ | — |
| 3 | 平方根 | ○ | ○ | C |
| 4 | 場合の数 | ○ | ○ | A |
| 5 | 条件付き確率 | ○ | ○ | B |
| 6 | 対数不等式 | ○ | ○ | B |
| 7 | 中央値 | ○ | ○ | B |
| 8 | 不偏分散 | ○ | ×(答え「4」) | A |
| 9 | 信頼区間の解釈 | ○ | ○ | C |
| 10 | p値の解釈 | ○ | ○ | C |
| 正答数 | 10/10 | 9/10 | ||
想定していた罠(問4の割り忘れ、問9・10の定義の取り違え)には、どちらも引っかかりませんでした。問5の条件付き確率も、4通りを書き出して1/3を導いています。この10問に関しては、生成AIの「解ける力」は統計検定2級レベルまで十分にある、と言ってよい結果です。
唯一の誤りは、想定と違うところで起きた
Gemini 3.6 Flash が問8で出した答えは「4」でした。私たちが罠として用意していた「n で割った標本分散」と同じ値です。ところが解説を読むと、n−1 で割るという定義は正しく押さえています。落ちたのは、その手前の足し算でした。
偏差の2乗和を「9+3+0+4+16=28」と書いています。正しくは32です。この28を7で割って、答えが4になりました。単純な加算ミスが、たまたま「もっともらしい誤答」と同じ数字を生んでいます。
ここに、AIで勉強することの本当の難しさがあります。
第一に、答えだけ見ても間違いだと分からない。「4」は分散の答えとして何の違和感もありません。
第二に、誤りは途中式に文字で書いてある。「9+3+0+4+16=28」は、読めば小学生でも気づける式です。しかし解説全体が整った体裁で、定義の説明も正確なので、読み手は「この解説は信頼できる」と判断し、足し算まで確かめません。信頼が検証を止める、という構造がそのまま出ています。
第三に、これは「難しい数学」の問題ではなく「検算する習慣」の問題だということです。この誤りに気づくのに必要なのは、不偏分散の深い理解ではありません。5つの数を足し直す手間だけです。気づける確率 s は、知識だけでなく、AIの出力を「読んで確かめる」という行動で上がります。
なお、これは各モデル1回ずつの結果です。同じ問題をもう一度聞けば違う結果になる可能性はあり、モデルの優劣を示すものではありません。
講師が見た、正答率より大事なこと
10問を投げて分かるのは、生成AIの正答率がかなり高いことと、それでも間違える問題があることの両方です。ここで大事なのは、間違えた問題の「気づける度」の分布です。
気づける度Bの問題は、具体例の代入や書き出しで検証できます。これは学習者に「検算する習慣」さえあれば防げます。
気づける度AとCの問題は違います。問4や問8は答えが非常にもっともらしく、問9や問10は定義を知らないと「何がおかしいのか」すら分かりません。この領域では、s はほぼゼロです。そして統計検定2級の出題の多くは、この定義の理解を問う型です。
Z世代が信頼しているのは48.5%、でも「間違えたときに気づけるか」を測ったものではありません。使っている本人の s が分からない以上、48.5%が高いのか低いのかは判断できない、というのが率直な読み方です。
では、講座は要るのか
結論を分けて書きます。
AIで独学できる範囲
すでに一度学んだ単元の復習、計算手順の確認、解き方が分かっている問題の類題演習。この範囲では s が高いので、AIの誤りは学習者が弾けます。実際、和からの受講生にもAIで演習量を増やして成績を上げた人が複数います。
講座が要る範囲
初めて学ぶ単元、定義の理解を問われる単元(確率、推定、検定)、そして「何を分かっていないのか自分で分からない」状態。ここでは s がゼロに近く、AIの誤りがそのまま知識になります。誰かが横で「そこは違う」と言う必要があります。
言い換えると、AIは s を持っている人の学習を加速し、s を持っていない人の学習を歪めます。講座の役割は、AIを使わせないことではなく、AIを使っても大丈夫な s を先に作ることです。
お子さんがAIで宿題をしている保護者の方へ
止める必要はありません。ただ、次の3つを確認してください。
1. 答えだけでなく、途中の説明を読んでいるか
2. 「本当か」を確かめる手段(教科書の定義、具体例の代入)を持っているか
3. 「AIが間違えた」経験を一度でもしたことがあるか
3つ目が特に重要です。AIが間違えるところを一度見た子は、以後の s が明らかに上がります。和からジュニアでは、この「AIが間違える瞬間」を授業の中で意図的に体験させています。
▶ 和からジュニア|小学生・中学生のための算数・数学 個別指導
まとめ
Z世代の6割以上が生成AIで勉強し、半数は信頼していない。この調査が示す本当の問いは「AIは信頼できるか」ではなく、「自分はAIの間違いに気づけるか」です。
間違いを覚える割合は (1 − p) × (1 − s)。AIの正答率 p は今後も上がりますが、それを掛け算で殺せるのは学習者の s だけです。s を作るのが学習であり、それをAIに代行させることはできません。
関連記事:
AIデスキリングとは?
オートメーション・バイアスとは?
同じことを生成AIに頼むなら、どう書けば思ったとおりに返ってくるのか。そのまま貼って使える「話しかけ方」を30個、A4・7ページにまとめました。資料づくり・メール・数字の整理・学び直しの、4つの場面別です。
和からのメルマガに登録すると、この資料を含む3本をまとめてお送りします。登録はメールアドレスだけ、30秒で終わります。
新着記事
同じカテゴリーの新着記事

同じカテゴリーの人気記事


この記事に関連する教室: 統計・データ分析教室 → 社会人の学び直し講座 →