モデル崩壊とは?|AIがAIの出力で学ぶと分散が消える仕組みを計算する
公開日
2026年9月8日
更新日
2026年10月16日
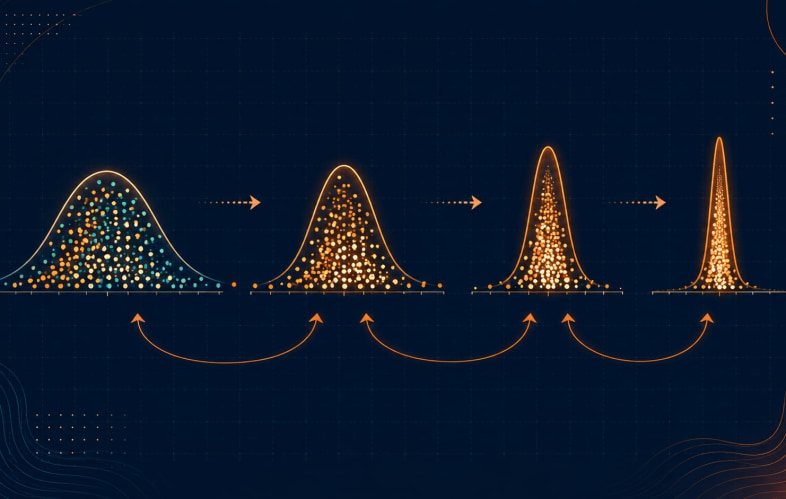
モデル崩壊(model collapse)とは、AIが生成したデータで次のAIを学習させる過程を繰り返すうちに、元のデータの特徴が失われ、モデルが劣化する現象です。とくに、出現頻度の低い事例が学習データから抜け落ちることが問題になります。
たとえば、よくある問い合わせには答えられても、珍しい故障や例外的な手続きに対応できなくなる、といった偏りです。まず具体例から意味と起こる条件を確認し、後半では正規分布の数値実験を使って、平均だけでは変化を見逃す理由を考えます。
この記事の主な内容
この記事のポイント
- AIの生成物を次の学習に使うと、元のデータにあった珍しい事例や多様性が失われることがあります。
- 起こり方は、元データを残すか、生成データをどう選ぶか、どのように再学習するかで変わります。合成データを使えば必ず崩壊する、という意味ではありません。
- 後半の数値実験は、仕組みを理解するための単純なモデルです。実際の言語モデルが何世代で劣化するかを予測するものではありません。
具体例:珍しい問い合わせが学習データから消える
ある会社に、商品の使い方に関する問い合わせが蓄積されているとします。多くは「初期設定の方法」ですが、少数ながら「特定の古い機種と接続するときだけ起きる不具合」も含まれています。以下は仕組みを説明するための架空の例です。
- 過去の問い合わせで学習したAIに、新しい問い合わせ例を生成させます。
- 生成された例の多くが、よくある初期設定の質問になります。珍しい不具合の質問はほとんど含まれません。
- 元の記録を使わず、生成された例だけで次のAIを学習させます。
- これを繰り返すと、珍しい不具合に関する情報がさらに少なくなる可能性があります。
普段の質問には答えられるため、全体の正答率だけでは変化に気づきにくいかもしれません。しかし、その不具合に困っている人には重要な情報です。モデル崩壊で問題になるのは、こうした「少ないけれど必要な事例」が失われることです。
統計では、確率分布の端にある出現頻度の低い部分を「裾」と呼びます。論文でいう「分布の裾が失われる」とは、こうした珍しい事例を十分に表せなくなることにつながります。ただし、少数の事例がすべて数値分布の裾に当たるわけではなく、ここでは直感を得るための例として使っています。
どのような条件で起こるのか
注意したいのは、生成データを作り、そのデータで次のモデルを学習させる流れが閉じた輪になる場合です。有限個の生成例には、元のデータの特徴をすべて正確に残せるとは限らないためです。
- 元データを残さず置き換える場合:生成時に抜け落ちた情報を、後の世代で取り戻しにくくなります。
- 元データや新たに確認したデータを加える場合:失われかけた特徴を補う余地があります。ただし、必要な量や方法は用途によって異なります。
- 生成データを選別する場合:品質確認や重み付けの方法によって結果は変わります。生成したものを無条件に正解として扱わないことが重要です。
なお、同じAIに文章の要約を何度も依頼するだけなら、通常はモデル自体を再学習していません。要約のたびに情報が抜け落ちる問題はありますが、この記事で扱うモデル崩壊とは区別します。
Nature論文は何を示したのか
Ilia Shumailovらの論文「AI models collapse when trained on recursively generated data」は、2024年7月24日に『Nature』で公表されました。生成モデルが作ったデータを次世代の学習に使うときの変化を、理論と実験で調べています。
論文では、珍しい事例に当たる分布の裾が失われる初期モデル崩壊と、元とは大きく異なる分布に近づく後期モデル崩壊を区別しています。また、有限サンプルによる統計的近似誤差、モデルの表現力の限界、学習手法による近似誤差を整理しています。
言語モデルの実験では、OPT-125mとWikiText-2を用い、生成した文章を使って次の世代を学習させています。元データを残さない条件で性能の劣化が見られた一方、元データを10%含める条件では劣化が比較的小さく抑えられました。
「10%残せば安全」という一般的な基準が得られたわけではありません。元データを残さない実験と10%含める実験では、学習エポック数もそれぞれ5回と10回で異なります。モデル、データ、学習設定を含めた、その実験条件での結果として読む必要があります。
数値実験:正規分布で「ばらつきが失われる」を考える
ここからは統計の仕組みを見ます。文章を生成するAI全体を再現するのではなく、有限個のサンプルで分布を推定し、その推定結果から次のサンプルを作る部分だけを取り出します。
平均0・分散1の正規分布から始め、毎世代100個のサンプルを取り、平均と不偏標本分散で次の正規分布を定める、と考えます。不偏標本分散は、偏差平方和をサンプル数nではなくn−1で割って求めます。
このとき、前世代の分散をVt−1、次世代の分散をVtとすると、分散の変化は次の式で表せます。
Vt=Vt−1×Zt/(n−1)
Ztは自由度n−1のカイ二乗分布に従い、世代ごとに独立に生成します。下の数値実験では、この式を直接使って分散の過程を計算しました。正規乱数を毎回100個生成する方法と、分散の変化について同じ確率分布になります。
初期分散1、n=100として100世代まで進める試行を2,000回行った結果です。Nature論文の実測値ではなく、本記事の説明用の数値実験です。
| 世代数 | 2,000試行の分散の平均 | 分散の中央値 | 分散が0.5以下の試行の割合 |
|---|---|---|---|
| 10世代 | 0.98 | 0.88 | 9.3% |
| 50世代 | 0.99 | 0.60 | 42.7% |
| 100世代 | 1.04 | 0.36 | 58.4% |
表の「平均」は、元の正規分布の平均値ではありません。2,000個の試行それぞれで得た分散を、試行間で平均した値です。100世代後の分散の平均は約1.04ですが、中央値は約0.36です。一部の試行では分散が大きくなり、全体の平均を押し上げています。
理論上の分散の期待値は、どの有限の世代でも1のままです。しかし、2,000回という有限回の試行から求めた平均が、必ず1に一致するわけではありません。
期待値が1でも、典型的な経路が縮む理由
分散は、世代ごとにランダムな倍率を掛けることで変化します。掛け算では、倍率の算術平均だけでなく、対数の平均が重要です。たとえば1.5倍と0.5倍は、倍率の算術平均こそ1ですが、続けて掛けると0.75倍になります。
このモデルの倍率をA=Z/(n−1)と置くと、E[A]=1です。一方、対数関数に対するイェンセンの不等式から、E[log A]<log E[A]=0となります。倍率にばらつきがあるため、不等号は厳密です。
対数を取った分散は、各世代のlog Aを足したものです。その平均的な増分が負なので、世代を限りなく重ねると、分散は確率1で0に向かいます。各有限世代で期待値が1であることと、ほとんどすべての経路で0に近づくことは両立します。不偏性は、個々の試行の分散を一定に保つ保証ではありません。
「半分になる世代数」は、何の目安か
nが十分大きい場合、1世代あたりの対数分散の期待変化はおよそ−1/(n−1)です。ここから、分散の幾何平均が半分になる世代数の目安を計算できます。
世代数の目安 ≈ log(2)×(n−1) ≈ 0.693×(n−1)
| 1世代あたりのサンプル数n | 上の近似式による目安 |
|---|---|
| 10 | 約6世代 |
| 100 | 約69世代 |
| 1,000 | 約692世代 |
| 10,000 | 約6,931世代 |
これは、各試行が初めて半分以下になる時刻や、その平均を求めたものではありません。算術平均の分散が半分になるわけでもなく、nが小さい場合には近似の粗さにも注意が必要です。まして、実際の言語モデルの寿命を示す数字ではありません。
この単純な条件では、サンプル数を増やすと典型的な縮小は遅くなります。ただし、元データを補充しない再帰生成を固定のサンプル数で続ける、という前提があります。現実の学習では、データの追加や選別などによって条件が変わります。
実務で確認したいこと
- 元データと出所を残す:AIが生成したもの、実際に観測したもの、人が確認したものを区別できるようにします。
- 珍しい事例を評価に含める:全体の平均点だけでなく、少数のカテゴリ、例外処理、重要な異常事例への対応を確かめます。
- 混合比率や選別方法を比較する:元データを何%残すかを一律に決めず、用途に合った評価用データで確認します。
- 再学習と要約を分けて管理する:モデルの更新による劣化なのか、資料の要約で情報が抜けたのかを区別します。
分散や分布の裾を業務でどう読むかは、社会人のための統計学・データ分析教室で扱っています。組織としてデータの見方を揃える場合は、統計・データ分析研修もご覧ください。
数値実験の再現条件
Python 3.12.14の標準ライブラリを使い、乱数シードを20261016に固定しました。外側のループを試行、内側を世代とし、1個の乱数生成器を全試行で継続使用しています。各世代でGamma分布(形状49.5、尺度2)から自由度99のカイ二乗変数を生成し、前世代の分散にその値を99で割った倍率を掛けます。正規分布の平均の推移は、この実装では計算していません。
import random
import statistics

rng = random.Random(20261016)
n, runs, generations = 100, 2000, 100
checkpoints = {10: [], 50: [], 100: []}

for trial in range(runs):
    variance = 1.0
    for generation in range(1, generations + 1):
        variance *= rng.gammavariate((n - 1) / 2, 2) / (n - 1)
        if generation in checkpoints:
            checkpoints[generation].append(variance)

for generation, values in checkpoints.items():
    fraction = sum(v <= 0.5 for v in values) / runs
    print(generation, statistics.mean(values),
          statistics.median(values), fraction)
10世代の「半分以下の割合」の出力は0.0925です。表では百分率にして小数第1位まで四捨五入し、9.3%と表示しています。他の割合も同様に表示しています。
よくある質問
モデル崩壊は実験で確認されているのですか
はい。紹介したNature論文では、特定の再帰学習の条件で理論的な分析と実験が行われています。ただし、その結果から、現在のすべての商用AIが同じように崩壊していると判断することはできません。学習データや更新方法を含む条件を確認する必要があります。
合成データは使わないほうがよいのですか
合成データは、足りない事例を補うなどの用途に役立つ場合があります。元データの保持、生成物の品質確認、独立した評価を含めて設計することが大切です。「AIが作った」という理由だけで、すべて同じ品質とは判断できません。
不偏推定量なら分散は減らないのではありませんか
不偏性が保証するのは期待値についての性質です。今回の単純モデルでは、分散の期待値は1のままでも、多くの試行の分散は小さくなります。試行間の平均と中央値、個々の経路を分けて考える必要があります。
自社の業務でも気をつける必要がありますか
AIが作ったデータやラベルを使ってモデルを繰り返し学習するなら、元データと珍しい事例が残っているか確認してください。再学習をせず資料の要約だけを繰り返す場合は、原本との照合や情報欠落の確認が中心になります。
参考・出典
- AI models collapse when trained on recursively generated data(Shumailov, Shumaylov, Zhao, Papernot, Anderson, Gal、『Nature』第631巻755〜759頁、2024年7月24日)
監修/和から株式会社 堀口智之
同じことを生成AIに頼むなら、どう書けば思ったとおりに返ってくるのか。そのまま貼って使える「話しかけ方」を30個、A4・7ページにまとめました。資料づくり・メール・数字の整理・学び直しの、4つの場面別です。
和からのメルマガに登録すると、この資料を含む3本をまとめてお送りします。登録はメールアドレスだけ、30秒で終わります。
新着記事
同じカテゴリーの新着記事
同じカテゴリーの人気記事


この記事に関連する教室: 統計・データ分析教室 → 社会人の学び直し講座 →